LAMMPS 덤프에서 z 방향 밀도 프로파일 계산
NOTE 35-10-01 · LAMMPS 덤프에서 z 방향 밀도 프로파일 계산
1. 일반 사항
A. 목적
- 이 노트는 슬랩 시뮬레이션 덤프에서 표면 수직 방향(z)의 수밀도 프로파일을 ASE와 pandas로 계산한다.
- 계산 결과를 LAMMPS
fix ave/chunk결과와 빈(bin) 단위로 대조한다. - 프로파일을 입력으로 받는 Gibbs 상대 표면 과잉량 함수를 제공한다.
참고
z 밀도 프로파일은 슬랩 시뮬레이션에서 가장 먼저 확인하는 양이다. LAMMPS 안에서 fix ave/chunk 로 바로 얻을 수 있지만, 이 노트는 계산을 파이썬 후처리로 옮긴다. 이유는 세 가지다.
- 빈 폭을 바꾸거나 종(type)별로 나눌 때 시뮬레이션을 다시 실행하지 않아도 된다.
- 벤젠/에탄올처럼 분자 단위로 다뤄야 하는 계는 원자가 아니라 분자 질량중심 기준이 필요하다. 이 처리는 후처리에서 쉽다.
- 밀도 프로파일은 다음 계산의 입력이다. 표면 과잉량, 층별 조성 같은 계산이 모두 이 배열을 받는다.
직접 작성한 코드는 한 번은 LAMMPS 내부 결과와 대조해야 한다.
B. 적용 범위
- LAMMPS 텍스트 덤프(
lammps-dump-text)에 적용한다. - 박스 크기가 변하지 않는 궤적에 적용한다. NPT 궤적은 3.B 의 경고를 따른다.
- 표면 과잉량 함수는 2성분 액체(용매 1, 용질 2)에 적용한다.
C. 결과 요약
- 고정층 빈(z = 0.125, 1.875 Å)의 값은 파이썬과 LAMMPS 모두 0.6122 로, 소수점 넷째 자리까지 같다.
- 가동층의 면 하나당 원자 수는 13개 면 모두 두 방법에서 128.0 이다.
- 가동층의 빈 단위 차이는 프레임 1장과 5000스텝 시간 평균의 차이에서 온다.
- 표면 과잉량 함수는 합성 프로파일 검사를 통과한다.
2. 준비 정보
A. 필요한 개념
- LAMMPS
compute chunk/atom과fix ave/chunk의 빈 정의를 알아야 한다. - pandas DataFrame 의 열 연산을 다룰 수 있어야 한다.
B. 참조 자료
| 참조 | 제목 |
|---|---|
| LAMMPS 가이드 cu-01 | 대조에 쓴 Cu(100) 슬랩 |
| Mishin 2001 EAM | Cu 퍼텐셜 Cu_mishin1.eam.alloy |
| Gibbs 상대 표면 과잉량 | 용매 과잉량이 0이 되도록 분할면을 잡는 정의 |
| NOTE 35-20-01 | PPPM vs MSM, Cu–벤젠–에탄올 (표면 과잉량 실제 값) |
C. 사용 프로그램
| 항목 | 용도 |
|---|---|
| Python, NumPy, pandas | 히스토그램, DataFrame 연산 |
ASE (ase.io.iread, ase.io.read) |
덤프 프레임 읽기, 데이터 파일 읽기 |
LAMMPS (EAM, fix ave/chunk) |
대조용 시간 평균 프로파일 |
D. 관련 파일
zprofile.py— 3.A 의 스크립트excess.py— 표면 과잉량 함수in.cu_slab— LAMMPS 입력 (EAM, Mishin 2001Cu_mishin1.eam.alloy필요)slab_final.dump,zdens.dat— 대조에 쓴 출력
3. 절차
A. 프로파일 스크립트 작성
- 아래 스크립트를
zprofile.py로 저장한다.
"""z-number-density profile per atom type from a LAMMPS dump (ASE + pandas).

usage: python zprofile.py dump.lammpstrj [dz]  ->  zprofile.csv
"""
import sys
import numpy as np
import pandas as pd
from ase.io import iread


def z_profile(dumpfile, dz=0.25):
    """Return a DataFrame: index = bin centre z (Å), one column per LAMMPS type,
    values = number density (atoms/Å^3) averaged over all frames in the dump."""
    counts, nframes, edges, area = {}, 0, None, None
    for atoms in iread(dumpfile, format="lammps-dump-text", index=":"):
        lx, ly, lz = atoms.cell.lengths()
        if edges is None:                       # bins fixed by the first frame
            edges = np.arange(0.0, lz + dz, dz)
            area = lx * ly
        z = atoms.positions[:, 2] - atoms.get_celldisp()[2]   # measure from zlo
        types = atoms.arrays["type"]            # ASE keeps the LAMMPS type here
        for t in np.unique(types):
            h, _ = np.histogram(z[types == t], bins=edges)
            counts[t] = counts.get(t, 0) + h
        nframes += 1
    centres = 0.5 * (edges[:-1] + edges[1:])
    df = pd.DataFrame({f"type{t}": c / (nframes * area * dz) for t, c in counts.items()},
                      index=pd.Index(centres, name="z"))
    df.attrs["nframes"] = nframes
    return df


if __name__ == "__main__":
    dump = sys.argv[1]
    dz = float(sys.argv[2]) if len(sys.argv) > 2 else 0.25
    prof = z_profile(dump, dz)
    prof.to_csv("zprofile.csv", float_format="%.6f")
    print(f"{prof.attrs['nframes']} frame(s), {len(prof)} bins of {dz} Å")
    print(prof[prof.sum(axis=1) > 0].head(8))
- 덤프 파일과 빈 폭(Å)을 인자로 주어 실행한다.
python zprofile.py slab_final.dump 0.25 # -> zprofile.csv
- 출력
zprofile.csv를 확인한다. 행은 빈 중심 z, 열은 type 이다.
참고
iread 는 프레임을 하나씩 넘겨주므로 수 GB 궤적도 메모리에 모두 올리지 않는다. 결과는 행이 z, 열이 type 인 DataFrame 하나이므로 이후 계산은 모두 열 연산으로 끝난다.
B. type 과 빈 원점 설정
경고
ASE는 LAMMPS type 을 원소로 읽지 않는다. specorder 를 주지 않으면 모든 원자가 H 로 들어온다.
- type 번호는
atoms.arrays["type"]에서 읽는다. type 번호만 쓸 때는 이 방법이 가장 혼동이 적다. - 원소 기호가 필요하면
iread(..., specorder=["Cu"])처럼 type 순서대로 원소를 넘긴다.
경고
ASE는 좌표를 덤프 값 그대로 두고, zlo 는 atoms.get_celldisp() 에 따로 넣는다. zlo 를 빼지 않으면 zlo = 0 일 때만 빈이 맞는다. zlo < 0 이면 아래쪽 원자가 히스토그램 범위 밖으로 오류 없이 빠진다. NPT처럼 박스가 변하는 궤적이면 “첫 프레임 빈 고정”도 다시 검토한다.
- z 좌표에서
atoms.get_celldisp()[2]를 빼서 박스 하단(zlo) 기준으로 측정한다. - 빈 경계를
np.arange(0.0, lz + dz, dz)로 잡는다. - 빈이 LAMMPS 와 같은지 확인한다.
compute chunk/atom bin/1d z lower 0.25 units box는zlo에서 시작하는 0.25 Å 빈이다.
C. 대조용 LAMMPS 계산 구성
- LAMMPS 가이드 cu-01 의 Cu(100) 슬랩을 준비한다.
- 면적은 8×8 단위격자이다.
- (100)면 13장, 1664원자이다.
- 맨 아래 두 면(z = 0, 1.81 Å, 256원자)을
setforce 0으로 고정한다. - 나머지 원자를 300 K NVT 로 적분한다.
- 10000스텝 동안 평형화한다.
- 이어서 5000스텝 동안
fix ave/chunk 100 50 5000으로 시간 평균 프로파일(zdens.dat)을 출력한다. - 마지막 프레임을
write_dump로 저장한다(slab_final.dump). - 3.A 의 스크립트로 마지막 프레임 하나를 읽는다.
참고
실제 분석에서는 production 구간 전체를 iread 로 읽어 평균한다. 이 대조에서 프레임 한 장만 쓰는 이유는 두 방법의 차이가 어디서 오는지 드러내기 위해서다.
D. 표면 과잉량 계산
- 2성분 액체의 Gibbs 상대 표면 과잉량을 다음과 같이 정의한다.
- 첨자를 정한다. 1은 용매(에탄올), 2는 용질(벤젠), 위첨자 b는 벌크 값이다.
참고 벤젠/에탄올 같은 2성분 액체가 Cu 위에 있으면, 프로파일에서 구하려는 양은 표면이 벌크보다 벤젠을 얼마나 더 붙잡는가이다. 이 정의는 용매의 과잉량이 0이 되도록 분할면을 잡으므로 분할면 위치를 따로 정할 필요가 없다.
- 3.A 의 DataFrame 에 아래 함수를 적용한다.
def surface_excess(prof, solute, solvent, z_wall, z_bulk_from, z_bulk_to):
    """Gibbs relative surface excess Γ_solute^(solvent) in molecules/Å^2."""
    bulk = prof.loc[z_bulk_from:z_bulk_to].mean()
    sel = prof.loc[z_wall:z_bulk_to]
    dz = np.diff(sel.index.values).mean()
    integrand = sel[solute] - bulk[solute] * sel[solvent] / bulk[solvent]
    return float(integrand.sum() * dz)
주의
분자 id 는 덤프에서 가져올 수 없다. 덤프에 mol 열을 넣어도 ASE의 dump 리더는 그 열을 버린다(확인됨).
prof의 열을 원자 type 이 아니라 분자 종으로 만든다.z_profile안에서 z 대신 분자 질량중심을 히스토그램에 넣는 버전을 쓴다.- 데이터 파일을
read("system.data", format="lammps-data", atom_style="full")로 읽는다. - 분자 id 를
atoms.arrays["mol-id"]에서 얻는다. - id 로 정렬된 덤프와 원자 순서가 같으므로 이 배열을 프레임마다 재사용한다.
4. 시험 및 검사
A. fix ave/chunk 와 대조
- 두 프로파일을 겹쳐 그린다.
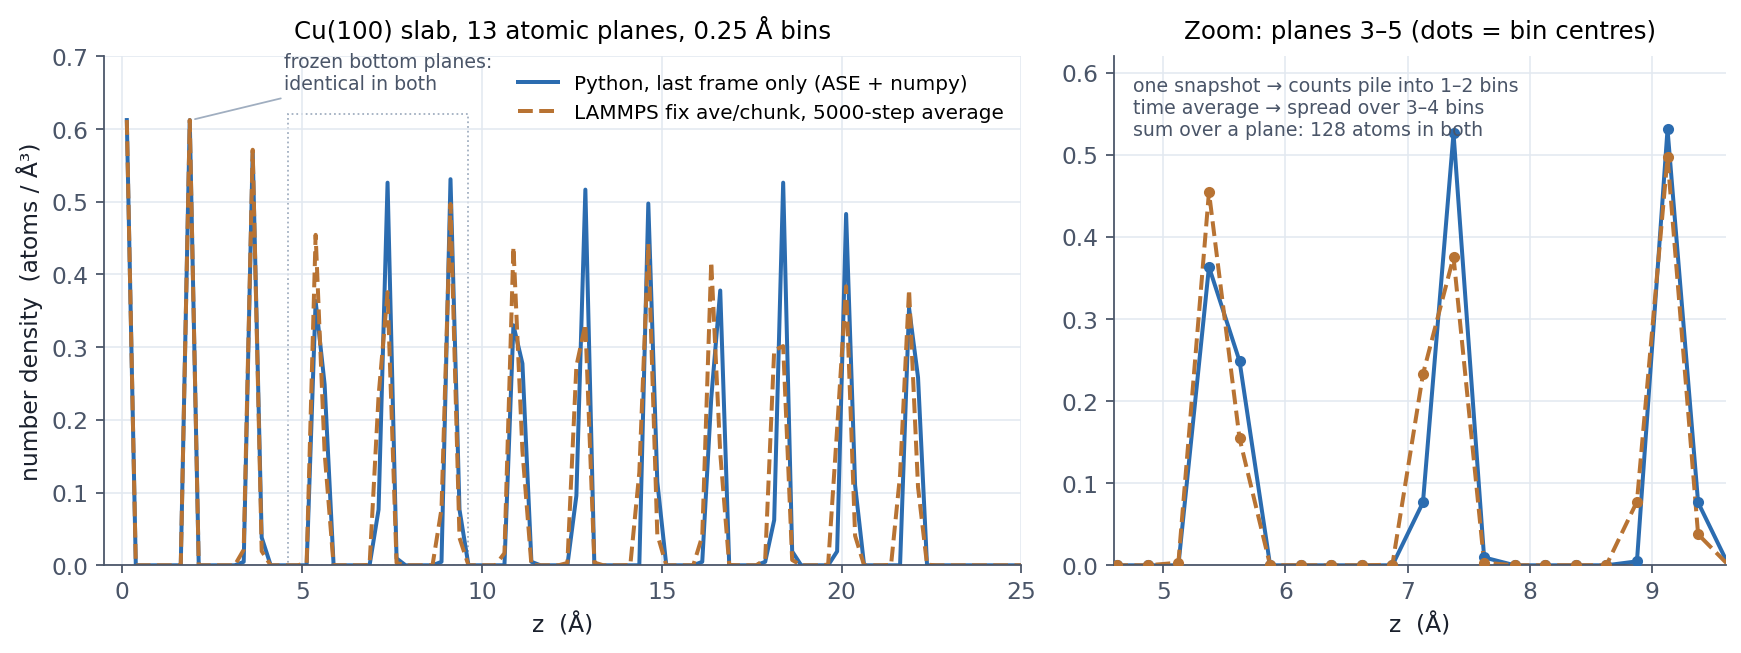
fix ave/chunk(5000스텝 평균). 오른쪽: 3–5번째 원자면 확대, 점은 빈 중심.- 구간별 값을 비교한다.
| 구간 | 파이썬 (프레임 1장) | LAMMPS (시간 평균) | 비고 |
|---|---|---|---|
| 고정층 z = 0.125, 1.875 Å | 0.6122 | 0.6122 | 소수점 4자리까지 동일 |
| 가동층, 면 하나당 원자 수 | 128.0 | 128.0 | 13개 면 전부, 면 주위 ±0.9 Å 빈 합 |
| 가동층, 빈 하나의 값 | 1–2개 빈에 몰림 | 3–4개 빈으로 퍼짐 | 열진동 때문 |
- 고정층 값을 먼저 판정한다. 소수점 넷째 자리까지 같으면 빈 원점과 면적·부피 정규화가 LAMMPS 와 같다. 합격이다.
- 가동층은 면 하나를 통째로 적분해 판정한다. 두 방법 모두 정확히 128 이므로 합격이다.
참고 고정층 값이 같은 것은 당연하지만, 빈 원점과 정규화가 맞는다는 증거이므로 가장 먼저 확인한다. 가동층은 빈 하나씩 비교하면 다르다. 스냅샷 한 장은 원자가 있는 빈에 카운트가 몰리고, 5000스텝 평균은 열진동으로 원자가 오간 범위만큼 퍼진다. 정규화는 맞고, 차이는 “한 장인가 평균인가”에서만 온다.
B. 표면 과잉량 함수 검사
- 두 성분이 벽 너머에서 균일한 합성 프로파일을 넣는다. 결과는 정확히 0이다.
- 벤젠에 가우시안 흡착 봉우리를 얹은 합성 프로파일을 넣는다. 봉우리 면적이 그대로 돌아온다.
5. 종료
A. 결과 정리
- ASE + pandas 스크립트는 빈 원점과 정규화가 LAMMPS
fix ave/chunk와 일치한다. - 빈을 맞추려면
zlo를 빼고, type 은atoms.arrays["type"]에서 읽는다. - 프로파일 DataFrame 은 표면 과잉량 같은 후속 계산의 입력으로 그대로 쓴다.
B. 후속 작업
- 벤젠/에탄올–Cu 계의 실제 표면 과잉량은 NOTE 35-20-01 에서 다룬다. 힘장·정전기 처리별로 이 값이 어떻게 달라지는지가 그 노트의 본론이다.