왜 두 단계인가
컨포머 공간을 DFT로 직접 훑기에는 너무 비싸고, xTB 에너지만으로 결론을 내리기에는 오차가 크다. 그래서 xTB로 후보를 넉넉히 모으고, 살아남은 몇 개만 DFT로 다시 계산해 순위를 정한다. xTB는 "어떤 구조들이 있는가"에, DFT는 "그중 무엇이 가장 안정한가"에 답하는 셈이다.
전체 흐름
- 출발 구조를 xtb로 최적화한다 (2장).
- CREST로 앙상블을 만든다 (5장).
- 에너지 창 안의 컨포머를 개별 xyz로 나눈다.
- 각각을 DFT로 재최적화한다. 여기서는 ORCA의 r2SCAN-3c와 CPCM(water)를 썼다.
- DFT 에너지로 다시 줄 세우고, 필요하면 상위 몇 개만 진동수까지 계산해 자유에너지로 비교한다.
앙상블 나누기
crest_conformers.xyz는 여러 프레임 xyz라서 몇 줄로 나눌 수 있다.
lines = open("crest_conformers.xyz").read().splitlines()
n = int(lines[0])
frames = [lines[i:i + n + 2] for i in range(0, len(lines), n + 2)]
for k, fr in enumerate(frames[:8], 1):
    open(f"conf{k:02d}.xyz", "w").write("\n".join(fr) + "\n")
DFT 재최적화
# conf01.inp ... conf08.inp
! r2SCAN-3c Opt CPCM(water)
%pal nprocs 8 end
%maxcore 1500
* xyzfile 0 1 conf01.xyz
r2SCAN-3c는 비용 대비 구조와 컨포머 에너지가 좋은 복합 방법이다(ORCA 가이드 12장). 컨포머 에너지 차이가 1 kcal/mol 안쪽으로 붙어 있어 순위가 중요하다면, 최종 단일점을 더 높은 수준으로 한 번 더 계산한다.
결과: 순위가 얼마나 바뀌나
CREST 상위 8개(GFN2 기준 0.49 kcal/mol 안)를 ORCA 6.1.0으로 하나씩 재최적화했다. 8개 모두 정상 종료했고, 최적화에 23~40 사이클이 걸렸다. 8코어에서 컨포머당 8~14분, 차례로 돌려 모두 86분이다. CREST 탐색 전체(3분 45초)보다 20배 넘게 오래 걸린 셈이다.
| CREST 순위 | ΔE GFN2 (kcal/mol) | ΔE r2SCAN-3c (kcal/mol) | DFT 순위 | φ / ψ 변화 |
|---|---|---|---|---|
| 1 | 0.00 | 0.55 | 6 | −83/73 → −86/73 |
| 2 | 0.32 | 0.55 | 7 | −83/72 → −86/73 |
| 3 | 0.41 | 0.65 | 8 | −144/164 → −156/154 |
| 4 | 0.48 | 0.00 | 3 | −104/161 → −62/145 |
| 5 | 0.49 | 0.00 | 1 | −107/160 → −62/145 |
| 6 | 0.49 | 0.00 | 2 | −107/160 → −62/145 |
| 7 | 0.49 | 0.00 | 4 | −99/161 → −63/145 |
| 8 | 0.49 | 0.01 | 5 | −88/163 → −62/145 |
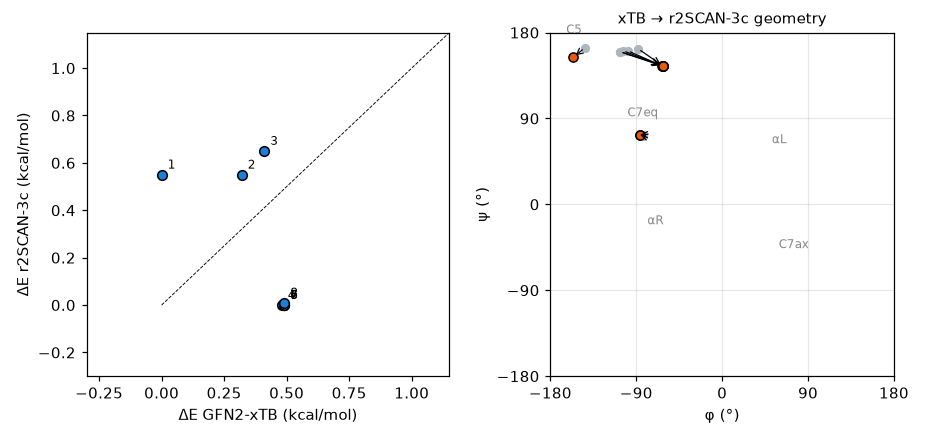
GFN2에서 가장 낮았던 C7eq(CREST 1, 2위)가 r2SCAN-3c에서는 0.55 kcal/mol 위로 올라갔고, 가장 낮은 자리는 펼친 구조가 차지했다. GFN2에서 φ/ψ가 −88°~−107°/160° 근처로 조금씩 달랐던 CREST 4~8위는 DFT 최적화 뒤 모두 −62°/145°의 한 구조로 모였다. 폴리프롤린 II(PII)나 β라고 부르는 영역이다. 무거운 원자끼리 맞춘 RMSD가 0.00 Å이고 에너지 차이도 0.01 kcal/mol 안이라, 표의 DFT 순위 1~5위는 사실상 같은 구조를 다섯 번 계산한 것이다. CREST 1위와 2위도 DFT에서는 같은 C7eq 구조(RMSD 0.01 Å)로 합쳐졌다. C5(CREST 3위)는 −156°/154°로 조금 움직여 0.65 kcal/mol에 남았다. 결국 8개 입력에서 서로 다른 DFT 극소는 세 개뿐이다.
순서는 뒤집혔지만 세 구조가 모두 0.7 kcal/mol 안에 있다. 이 정도 차이는 r2SCAN-3c 같은 방법의 전형적인 오차와 비슷한 크기라서, "물에서는 PII/β가 가장 안정하다"고 이 계산만으로 단정할 수는 없다. 게다가 여기 비교한 것은 연속체 용매 안의 전자 에너지뿐이고, 영점 에너지와 열 보정, 엔트로피는 들어 있지 않다. 알라닌 다이펩타이드는 기체상과 물에서 선호하는 구조가 다르고, 물에서는 PII/β와 αR이 많이 채워진다고 알려져 있다. 분자 내 수소결합에 기대는 C7eq는 물과의 수소결합이 빠진 연속체 모델에서 유리하게 나올 수 있다. 정량적인 분포가 필요하면 자유에너지 보정과 명시적 용매까지 고려해야 한다. 이 예제에서 분명하게 말할 수 있는 것은 GFN2의 순위를 그대로 믿으면 안 된다는 점, 그리고 xTB에서 여러 개로 보이던 구조가 DFT에서 하나로 합쳐질 수 있다는 점이다.
실전 팁
- 재최적화 중 합쳐지는 컨포머: 이 예제에서는 8개가 3개로 줄었다. xTB에서 다른 극소였던 구조가 DFT에서는 같은 구조로 수렴하기도 하니, DFT 구조끼리 다시 RMSD로 중복을 걸러 낸다(
crest --cregen). - 몇 개까지: 상위 몇 개가 아니라 에너지 창으로 고른다. 보통 GFN2 기준 3~6 kcal/mol 안의 컨포머를 DFT로 넘긴다. 이 예제의 상위 8개는 GFN2 기준 0.49 kcal/mol 안에 몰려 있어서 C7ax(1.13 kcal/mol)나 αR 쪽 컨포머는 한 번도 DFT로 계산하지 않았다. DFT에서 상대 에너지가 0.5 kcal/mol씩 움직인 것을 보면, 이런 구조도 넘겨 봐야 했다.
- 전자 에너지와 자유에너지: 순위가 1 kcal/mol 안에서 갈리면, 남은 극소 몇 개에 진동수를 계산해 자유에너지로 비교한다. 합쳐진 뒤에는 극소가 몇 개 안 되므로 비용도 크지 않다.
- 자동화 도구: 이 과정을 여러 단계로 자동화한 CENSO가 있다. 컨포머가 수십 개 이상이면 고려할 만하다.